Comment je transforme les vidéos YouTube en podcast personnel
J’ai demandé à Hermes, l’agent IA qui tourne sur mon VPS, de me construire un flux RSS personnel alimenté par de simples liens Telegram : ce qu’il a bâti en une heure et demie, ce que YouTube a cassé, et les quatre contrôles qui évitent les faux succès.
Greg Taieb · · 8 min de lecture
YouTube est rempli d’interviews et de conférences que j’ai envie d’écouter, pas de regarder. Vingt minutes, ça passe. Une heure trente, non : l’écran reste allumé, les recommandations me détournent, et je ne retrouve pas toujours l’endroit où je m’étais arrêté.
Je voulais traiter ces vidéos comme des épisodes de podcast : les lancer depuis Pocket Casts, mon application de podcast, verrouiller l’écran, reprendre plus tard, écouter en voiture. Sans installer un outil de plus ni copier des fichiers sur mon téléphone.
J’ai donc décrit ce besoin à Hermes, l’agent IA open source de Nous Research qui tourne en permanence sur mon serveur. C’est le même que nous installons chez les clients de Levolia. La mise en place a pris une heure et demie, au maximum.
Un message Telegram, et l’épisode arrive
L’interface tient dans un message. Je colle une URL YouTube et je demande de l’ajouter à mon podcast. Hermes identifie la vidéo, récupère le titre, l’auteur et la durée, prépare l’audio, puis me répond quand l’épisode est disponible. Il faut compter cinq minutes environ, davantage pour une vidéo longue. Je rafraîchis Pocket Casts et il est là.
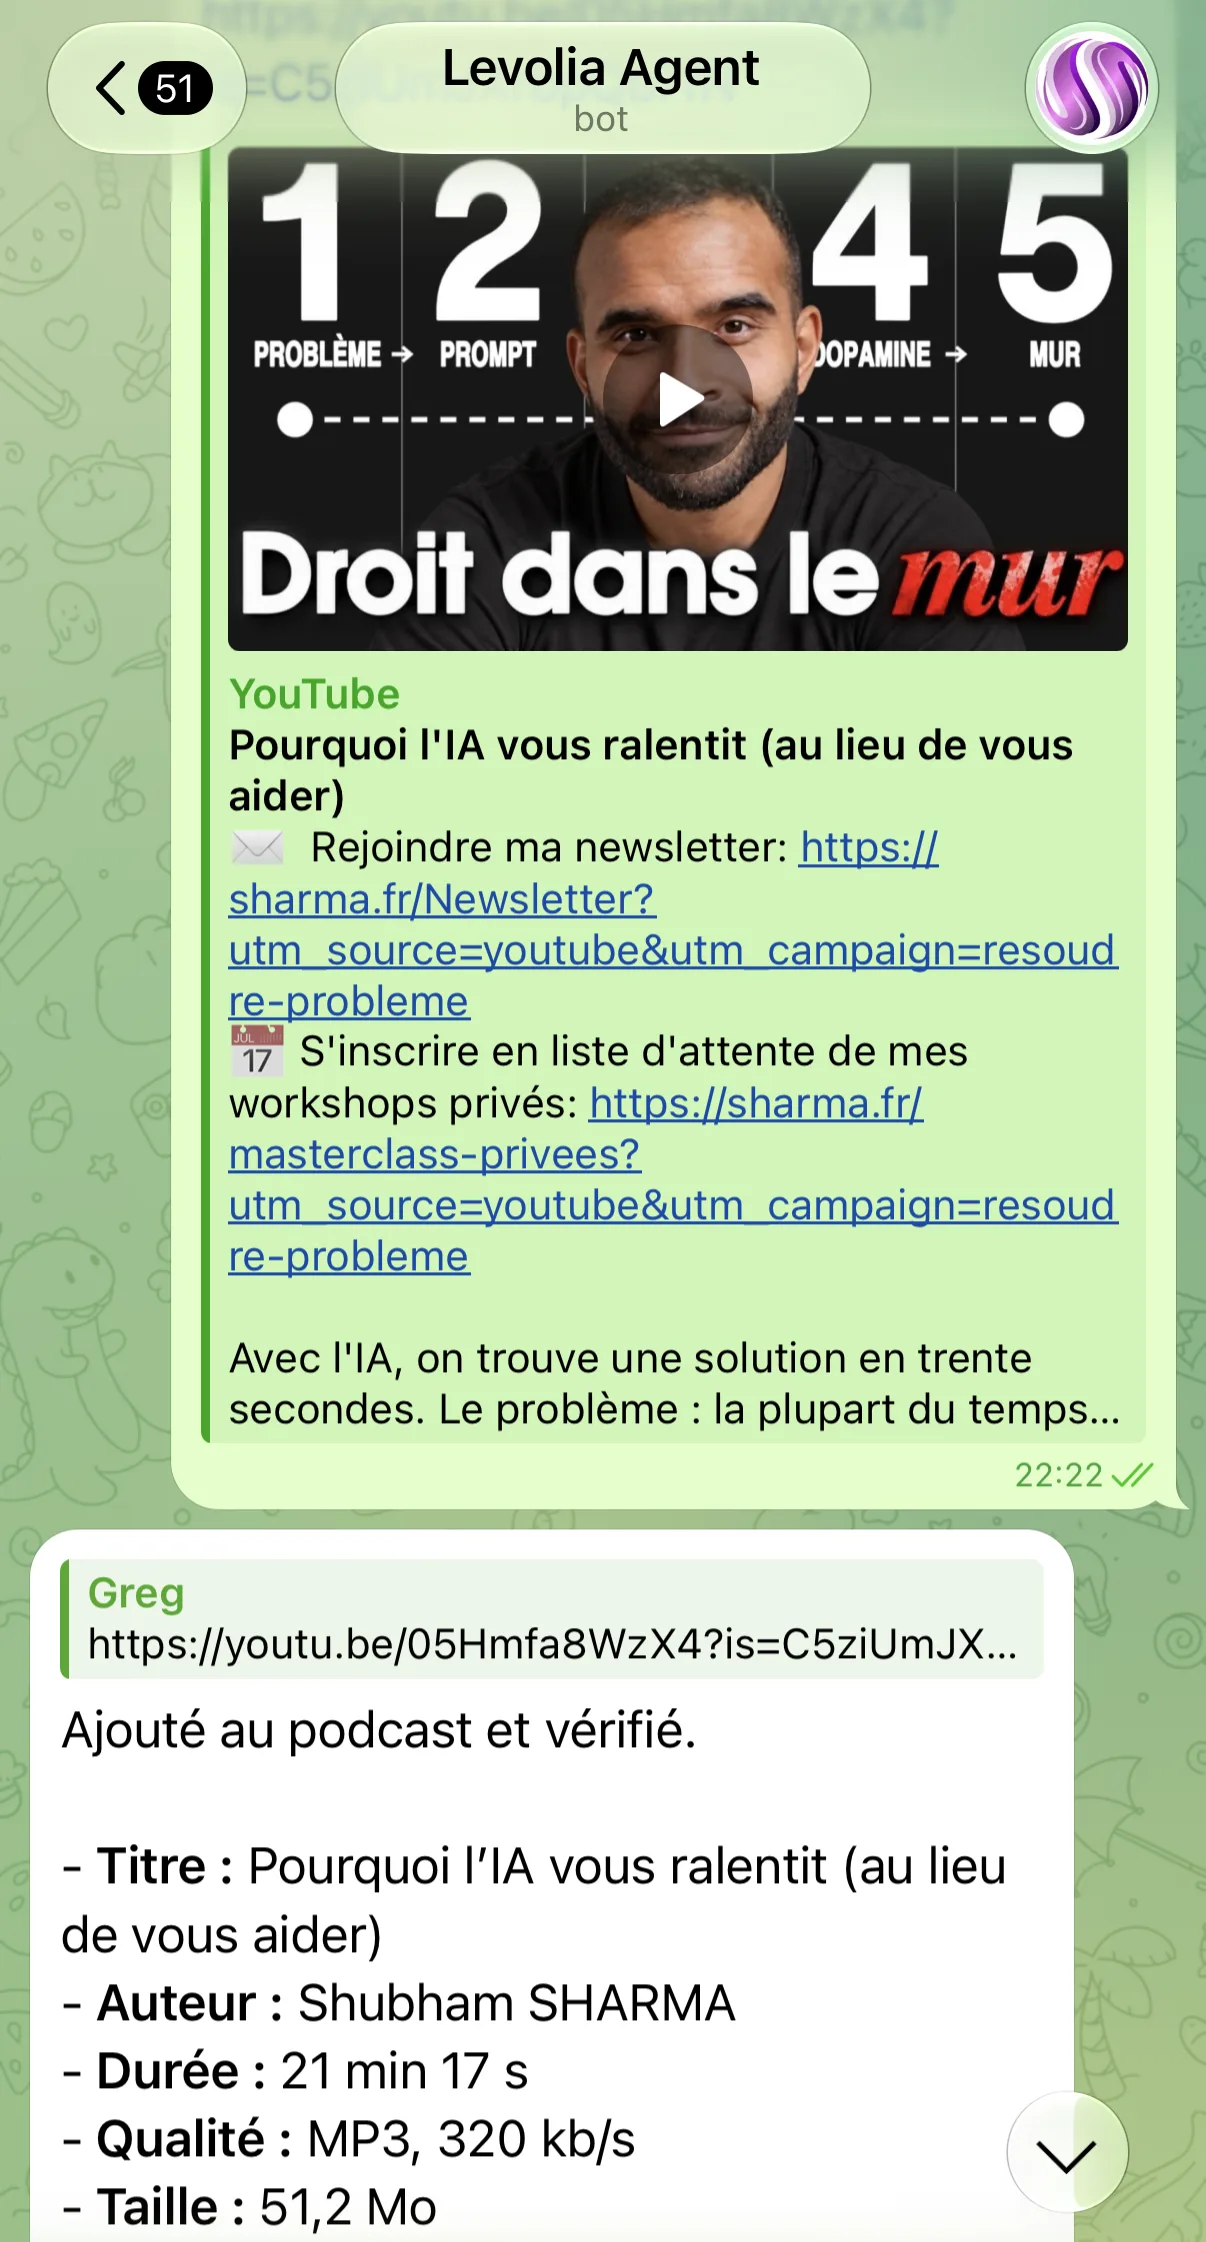
Le 12 novembre à 22h22, par exemple, je lui ai envoyé « Pourquoi l’IA vous ralentit (au lieu de vous aider) », une vidéo de Shubham Sharma. Sa réponse : « Ajouté au podcast et vérifié », avec le titre, l’auteur, la durée (21 min 17 s), la qualité (MP3, 320 kb/s) et la taille (51,2 Mo).
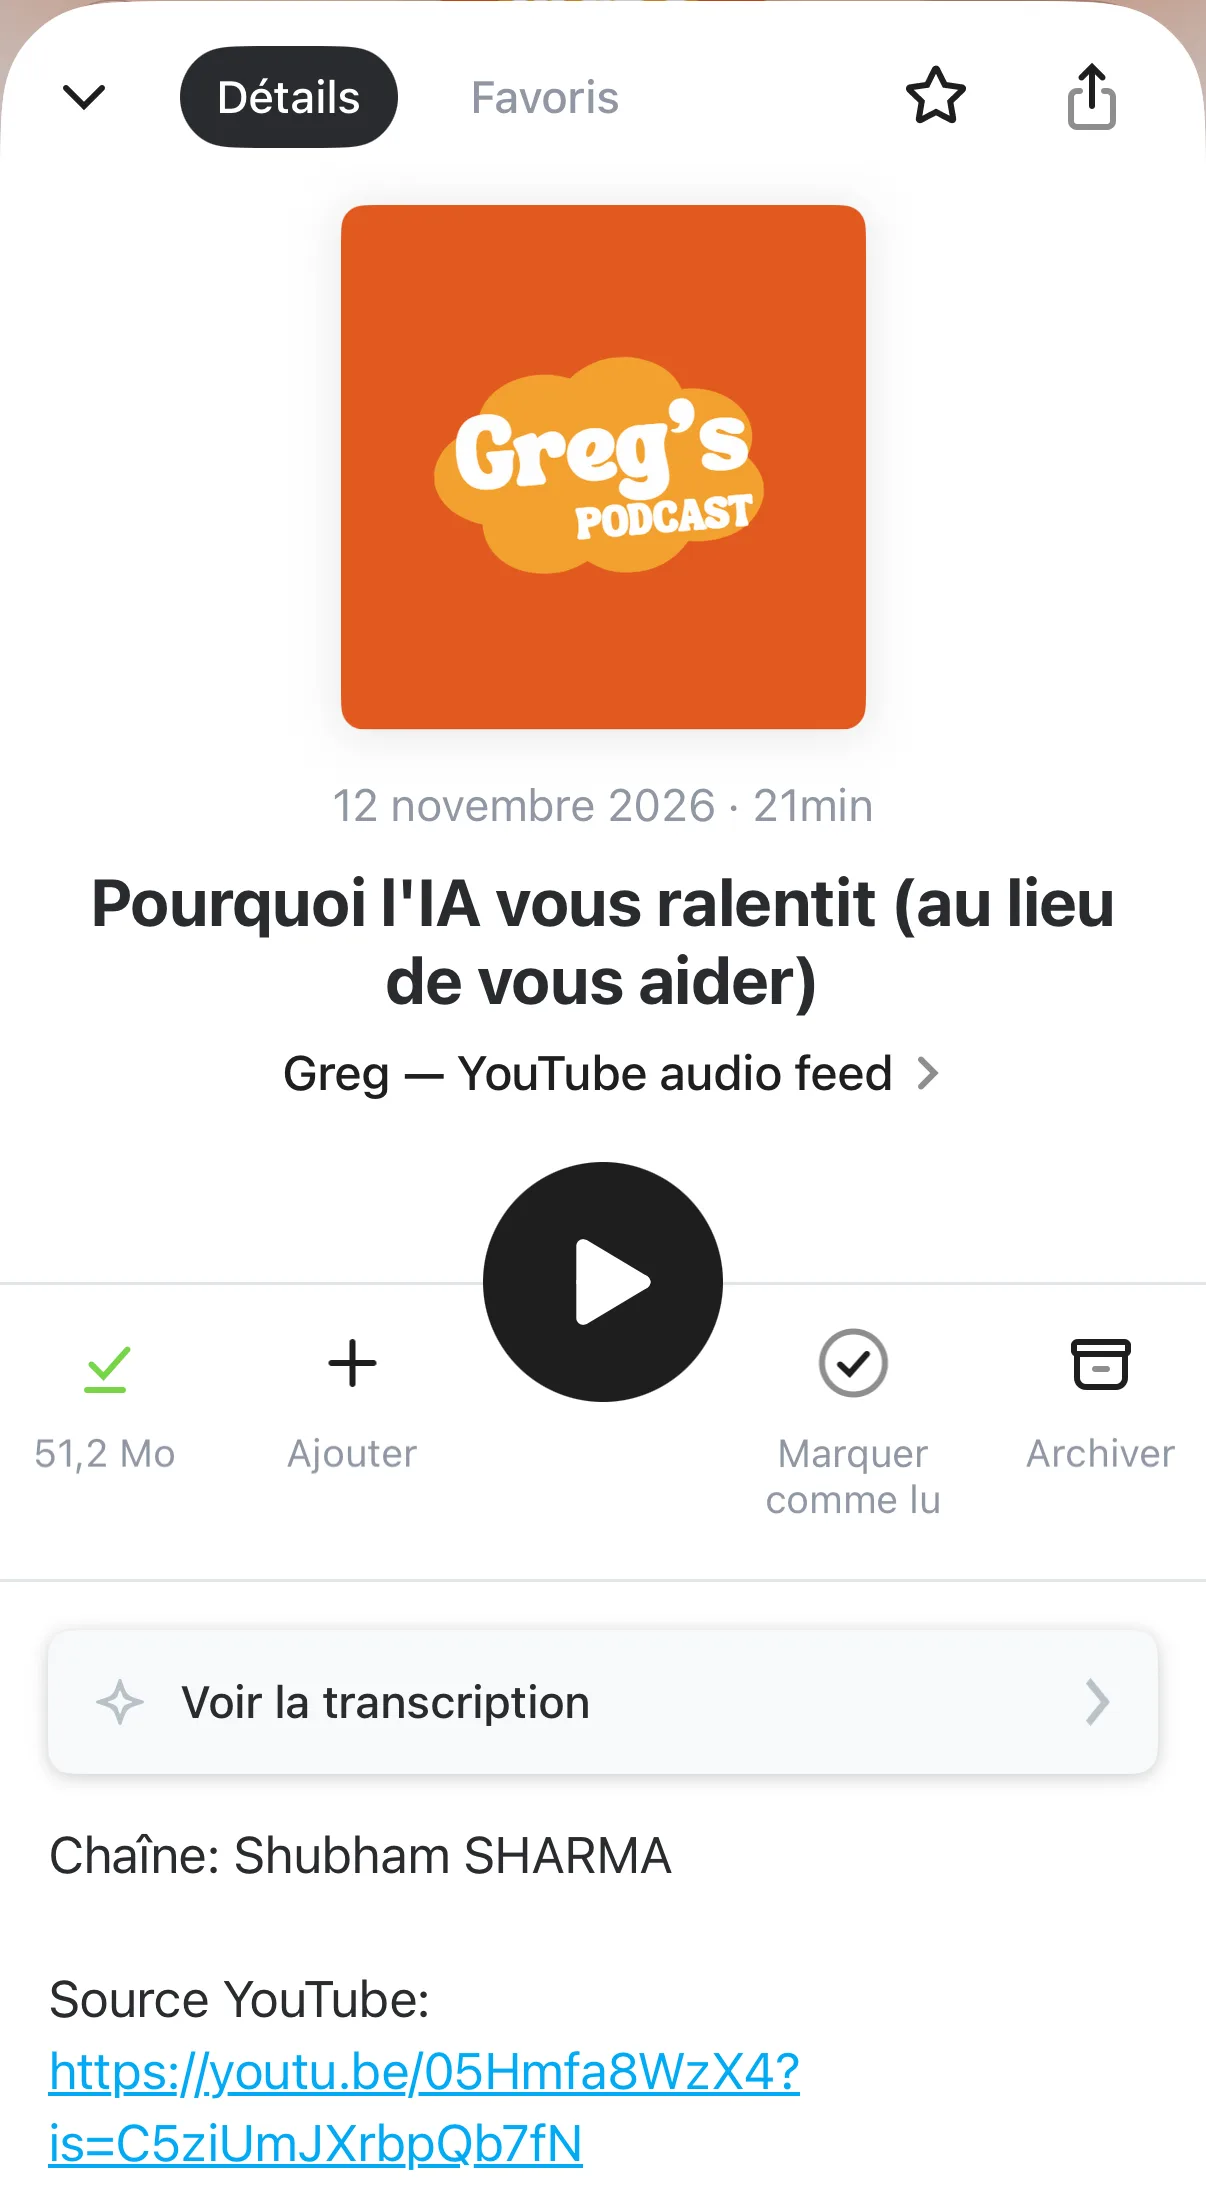
Je m’en suis servi aussi pour une conversation de 49 minutes et un entretien de 1 h 39. Ce dernier pèse 238,7 Mo, parce que le réglage de départ encodait tout à 320 kb/s, un débit pensé pour la musique. Il a été corrigé pendant l’écriture de cet article, j’y reviens plus bas. En pratique, le poids gênait peu : le fichier reste sur le serveur et l’application le lit à distance, comme n’importe quel épisode.
Je ne convertis pas des chaînes entières. Je choisis les vidéos une par une, ce qui évite de remplir le flux d’épisodes que je n’écouterai jamais.
Je n’ai rien codé : Hermes a construit le système et le fait tourner
Je n’ai pas développé cette solution, ni rédigé de cahier des charges. Hermes a conçu l’architecture, écrit les scripts, créé le flux RSS, organisé le stockage et configuré la diffusion des fichiers depuis le serveur. Il a aussi installé les tâches qui surveillent le service et le nettoyage régulier qui supprime du serveur les épisodes déjà écoutés.
Surtout, il a exécuté ce qu’il écrivait. Il a lancé les scripts sur le VPS, lu les erreurs réelles, essayé d’autres méthodes quand YouTube refusait la première, puis vérifié le résultat depuis l’adresse du podcast.
Le même agent est donc à la fois le développeur, l’exploitant du serveur, le testeur et l’interface. C’est une délégation plus large que celle que je décrivais dans mon test de 75 jours avec un assistant personnel : là-bas, l’agent utilisait des services existants ; ici, il fabrique le service.
Le flux RSS compte plus que le MP3
Un MP3 seul ne règle rien : il faudrait encore le transférer, le ranger et retrouver ma position d’écoute. Le flux RSS, lui, transforme un dossier de fichiers en podcast. Je l’ai ajouté une seule fois dans mon application, à une adresse qui ne change pas.
Trois détails font que cela fonctionne vraiment :
- La balise
enclosure. Chaque épisode déclare son fichier avec le typeaudio/mpeg: c’est ce que prévoit la spécification RSS pour qu’une application trouve l’audio. - La date de publication. Elle correspond au moment où j’ajoute la vidéo, pas à sa mise en ligne sur YouTube. Sinon, une vieille vidéo ajoutée aujourd’hui se retrouverait enterrée plusieurs années en arrière dans l’application.
- La lecture partielle. Une application de podcast ne télécharge pas toujours le fichier entier : elle en demande des portions avec des requêtes HTTP Range. Après chaque ajout, Hermes demande les 2 048 premiers octets du fichier pour vérifier que le serveur répond correctement.
Avant de publier, il contrôle aussi la durée, le débit et la taille avec FFprobe, puis enregistre l’épisode dans un catalogue local : identifiant YouTube, titre, auteur, durée, date d’ajout, chemin et taille du fichier.
YouTube bloque, et c’est là que tout se joue
Sur le papier, le scénario tenait en trois verbes : télécharger, convertir, publier. En pratique :
- YouTube bloque l’adresse IP du serveur et demande une connexion pour prouver qu’on n’est pas un robot ;
- un cookie expire ;
- un service externe refuse une vidéo longue ;
- une conversion annonce un succès, mais le « MP3 » est une page HTML d’erreur ;
- un lien audio fonctionne quelques minutes, puis disparaît.
J’ai arrêté de voir ces incidents comme des exceptions : ils font partie du produit. Hermes conserve plusieurs méthodes de récupération et passe à la suivante quand l’une échoue.
C’est tout l’intérêt des skills d’Hermes. Un skill est une méthode que l’agent mémorise : ici, la marche à suivre pour passer d’une URL à un épisode vérifié. Et Hermes est auto-apprenant : chaque fois qu’il détecte un changement, ou que nous améliorons la procédure ensemble, il met lui-même le skill à jour. La solution trouvée un jour reste disponible pour la fois suivante.
C’est ce qui rend Hermes aussi puissant. C’est aussi pour cela qu’il est rarement plug & play : avant d’obtenir un service fiable, il a fallu cette heure et demie d’allers-retours, et la méthode continue de s’affiner à l’usage. D’autres outils, comme Instinct, l’assistant de mon test de 75 jours, sont prêts à l’emploi dès l’inscription.
Un script qui se termine sans erreur ne prouve pas que l’épisode est écoutable. L’ajout n’est donc déclaré terminé qu’après quatre contrôles :
- le MP3 existe et c’est bien un fichier audio ;
- sa durée est plausible ;
- le flux RSS public contient l’épisode ;
- le serveur accepte la lecture partielle.
C’est ce que résume le « vérifié » de sa réponse sur Telegram.
Pendant l’écriture de cet article, le système s’est amélioré
J’ai fait relire et corriger cet article par Claude, captures d’écran comprises. En lisant la réponse de l’agent, Claude a relevé une incohérence : 238,7 Mo pour 1 h 39, cela correspond à environ 320 kb/s, un débit inutile pour de la voix. Entre 64 et 96 kb/s, le même fichier pèserait 50 à 70 Mo.
Le 13 novembre à 7h20, j’ai transmis la remarque telle quelle à Hermes sur Telegram. Deux minutes plus tard, il répondait : « Tu as raison. 320 kbit/s est inutile pour un podcast parlé. » Les nouveaux épisodes sont désormais encodés en MP3 mono à 80 kb/s. À durée égale, l’entretien de 1 h 39 pèserait environ 59,6 Mo au lieu de 238,7 Mo, quatre fois moins.
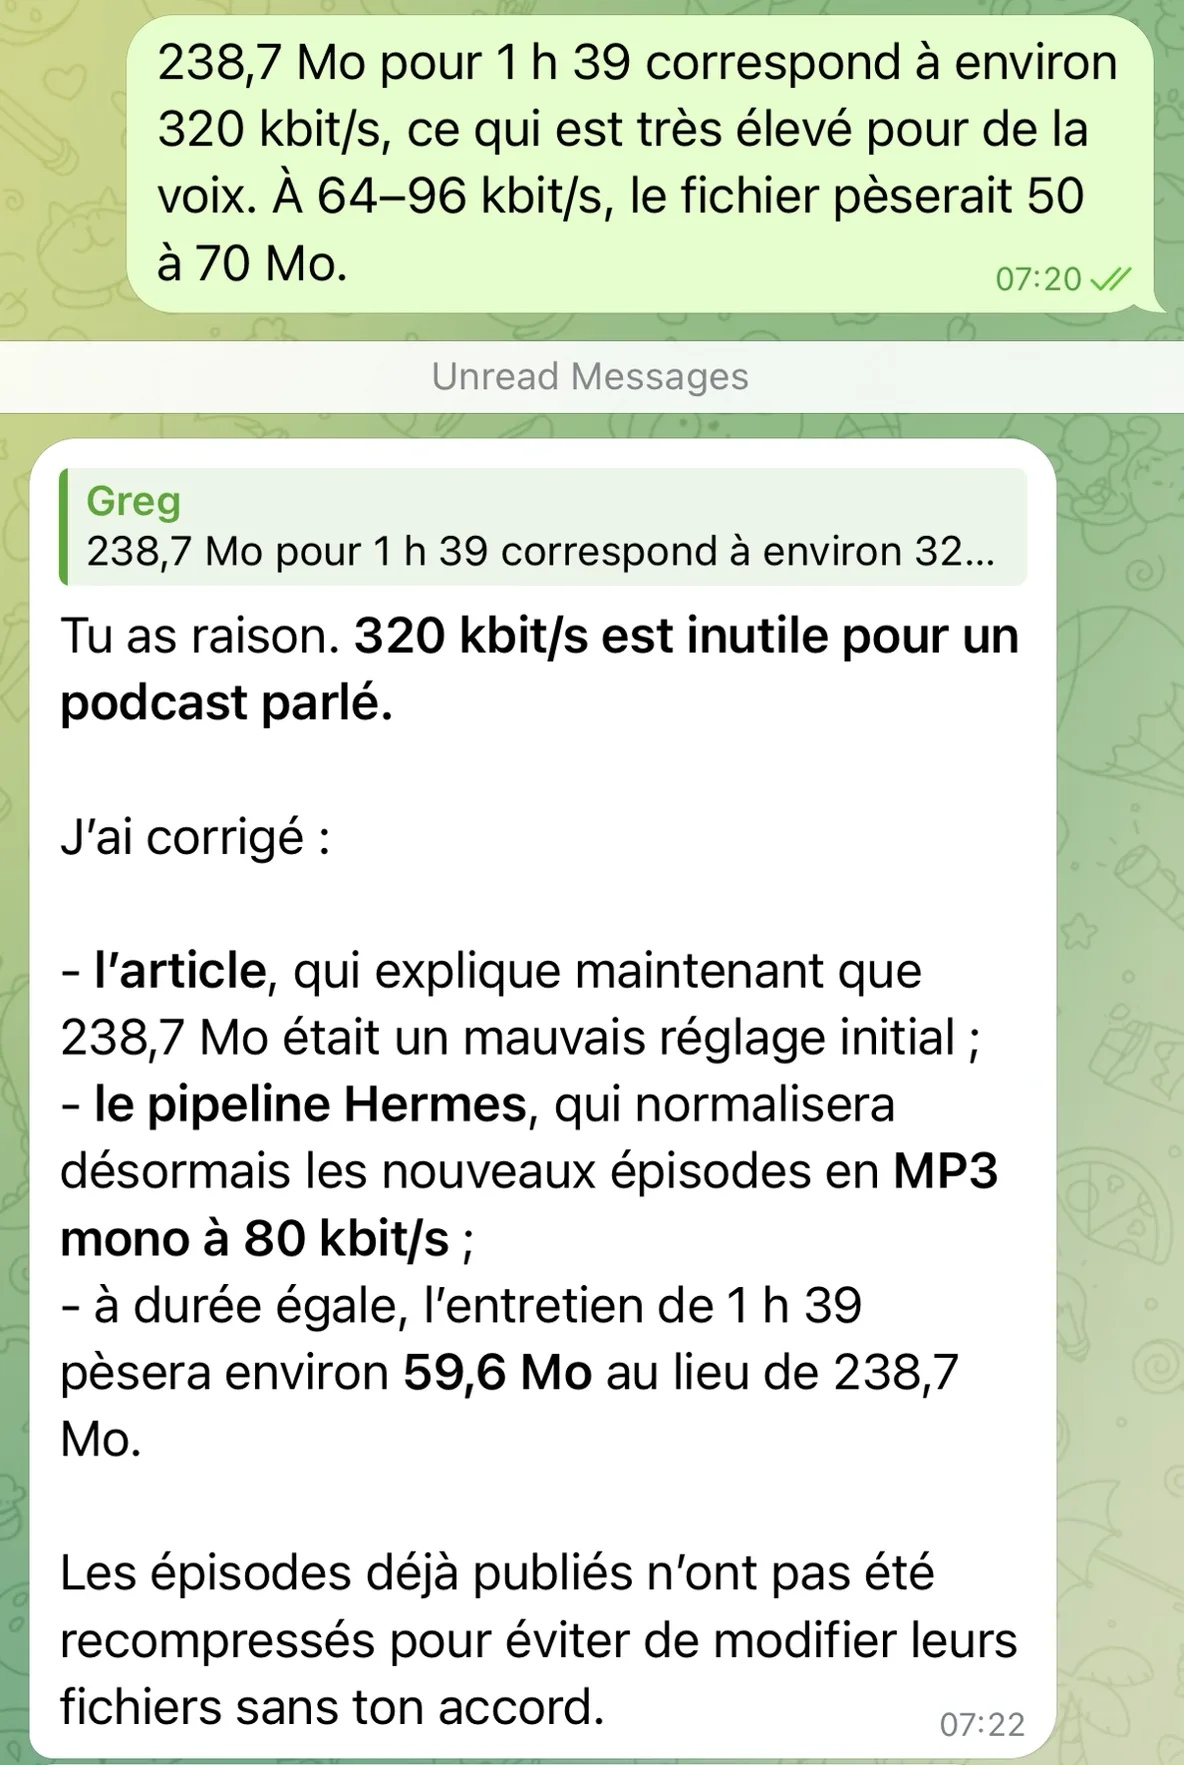
Un détail me plaît : il n’a pas recompressé les épisodes déjà publiés, « pour éviter de modifier leurs fichiers sans ton accord ». La correction s’applique à tout ce qui vient ensuite, sans toucher à l’existant.
C’est la boucle décrite plus haut, en conditions réelles : un constat, une phrase sur Telegram, et le nouveau réglage devient la règle par défaut. Je n’ai ouvert ni fichier de configuration ni terminal.
Ce qui existait déjà, et ce que l’agent change
Rien de tout cela n’est une prouesse technique. YouTube Premium permet déjà d’écouter écran verrouillé. Des projets libres comme Podsync convertissent des chaînes YouTube en flux de podcast. Un développeur à l’aise avec la ligne de commande n’y verrait rien d’insurmontable.
Ce qui change, c’est qui fait le travail. Il y a un an, pour obtenir ce résultat sans coder, j’aurais dû installer et configurer un de ces outils, puis le réparer moi-même à chaque blocage de YouTube. Ou lancer un petit projet logiciel, avec un backend, une interface pour coller les liens et un serveur à surveiller. Pour un besoin d’une seule personne, l’effort était disproportionné, et j’y aurais renoncé.
Ici, je n’ai rien installé, et il n’y a ni tableau de bord ni formulaire. J’ai décrit le résultat attendu en une heure et demie d’échanges, et l’agent a construit la capacité correspondante sur mon serveur. Quand YouTube bloque, c’est lui qui cherche un autre chemin.
Un flux personnel, pas une rediffusion
Ce système sert à mon écoute personnelle. Je ne republie rien sous mon nom. Soyons précis : le flux est techniquement public, quiconque connaît son adresse peut le lire. Mais cette adresse n’apparaît nulle part, et les épisodes écoutés sont supprimés du serveur.
Cela ne rend pas le montage neutre pour autant. Les conditions d’utilisation de YouTube interdisent de télécharger un contenu sans autorisation de la plateforme ou de l’ayant droit, et les droits des auteurs s’appliquent quelle que soit la méthode. Chacun doit regarder cette limite en face avant de reproduire l’idée. De mon côté, je m’en tiens à un usage privé et temporaire.
Ce que j’en retiens
Partir d’un geste que je fais déjà. Je partage des liens sur Telegram toute la journée. Aucune nouvelle application à ouvrir, donc aucune raison d’abandonner au bout d’une semaine.
Sortir dans un format que mes outils connaissent. Le RSS a plus de vingt ans, et toutes les applications de podcast savent déjà gérer la lecture, la reprise et le téléchargement.
Juger un agent sur ses vérifications. L’interface peut tenir dans une URL si l’exécution derrière est solide : les chemins de secours et le contrôle final comptent plus que le script de conversion.
Ma liste « À regarder plus tard » grossissait plus vite que mon temps disponible. Maintenant, quand un entretien de 90 minutes apparaît dans mon fil, j’envoie le lien à Hermes et je l’écoute en marchant.